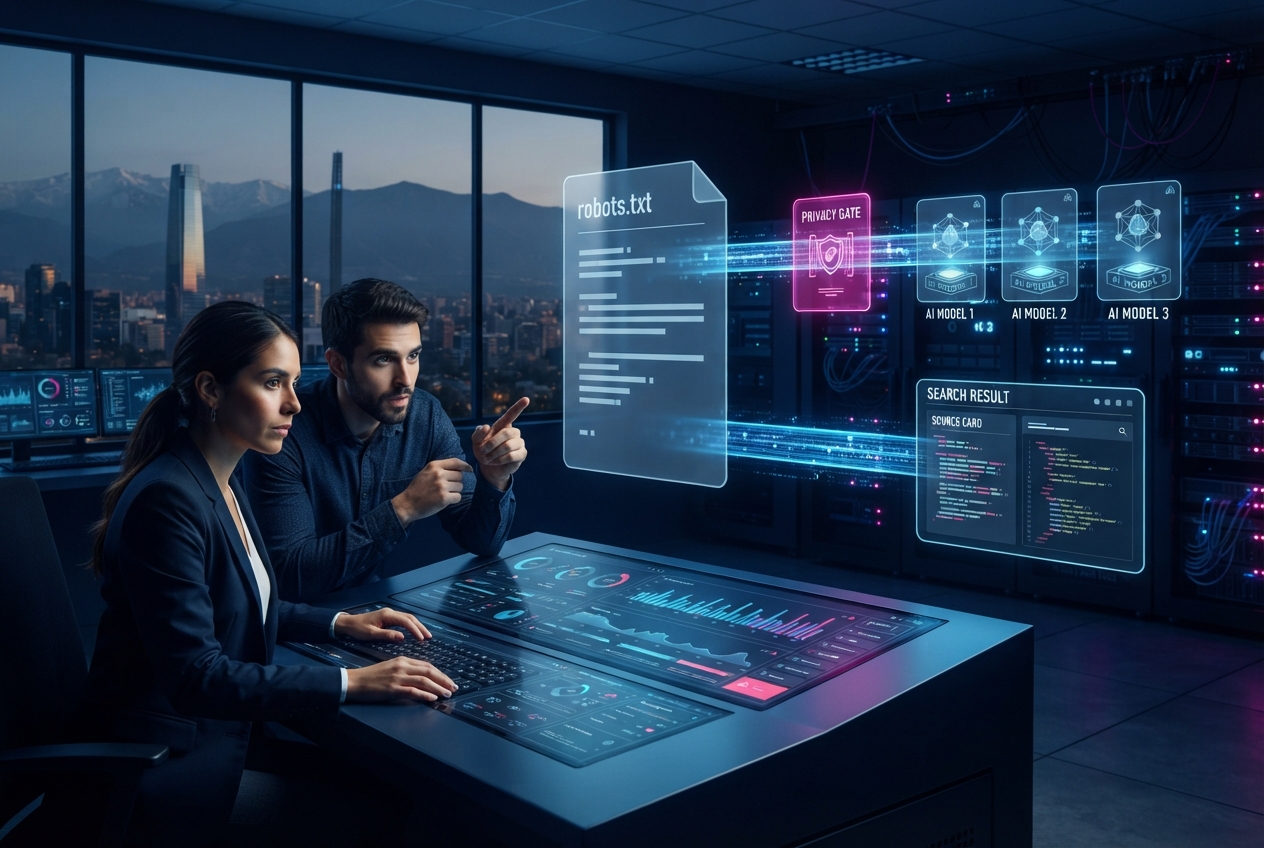

Respuesta directa. El nuevo control robots.txt para IA permite que un sitio declare, mediante el token común __usage_ai-training, si autoriza o rechaza que su contenido se use para entrenar modelos generativos. OpenAI anunció que respetará esta señal y el borrador técnico de la IETF también recibió respaldo de Google y Microsoft. La decisión no equivale a bloquear el rastreo, no elimina automáticamente una página de los buscadores y no debería confundirse con impedir que ChatGPT u otros asistentes citen una fuente en una respuesta actual.
Qué cambió el 30 de octubre de 2026
La administración de permisos para inteligencia artificial venía fragmentándose. Un publisher debía identificar los rastreadores de cada compañía, comprender para qué servía cada uno y mantener reglas independientes. En OpenAI, por ejemplo, GPTBot se relaciona con entrenamiento, mientras OAI-SearchBot permite que páginas web aparezcan como fuentes en las funciones de búsqueda de ChatGPT. Google utiliza Google-Extended para determinados usos de Gemini, y otros proveedores mantienen sus propios nombres y políticas.
OpenAI comunicó este viernes que apoyará una señal común en robots.txt para que los operadores expresen una preferencia de entrenamiento una sola vez ante los proveedores participantes. La empresa aclaró que busca implementarla durante los próximos meses y que sus controles actuales seguirán funcionando. Por lo tanto, no se trata de un cambio que deba aplicarse a ciegas ni de una sustitución inmediata de todas las reglas existentes.
El anuncio se apoya en el borrador Machine-Readable Training Preference Signal, publicado en la Internet Engineering Task Force (IETF). Microsoft presentó en paralelo preferencias separadas para entrenamiento y grounding en Bing, sin cambiar la elegibilidad para sus resultados de búsqueda. Google también informó que planea admitir el control compartido en 2027. La coincidencia de tres actores relevantes convierte una discusión técnica en una decisión editorial y de gobierno de datos para medios, universidades, comercios y empresas chilenas.
Nota de Entidad: IETF y el protocolo robots.txt
La Internet Engineering Task Force desarrolla estándares abiertos para Internet. El documento del 30 de octubre es un Internet-Draft, es decir, un trabajo en progreso y no un RFC definitivo. Su vigencia declarada llega al 3 de mayo de 2027 y puede actualizarse, reemplazarse o quedar obsoleto. El mecanismo conserva la estructura del Robots Exclusion Protocol normalizado en el RFC 9309: usa grupos User-Agent, reglas Allow y Disallow, y la precedencia de la coincidencia de ruta más extensa.
Fuentes: anuncio oficial de OpenAI y borrador técnico publicado por la IETF.
Cómo funciona el token __usage_ai-training
El borrador no inventa una nueva directiva. Define un token de política que se escribe como si fuera un agente de usuario. Una declaración básica contra el entrenamiento para todo el sitio se vería así:
User-Agent: __usage_ai-training
Disallow: /
También puede establecerse una excepción. Si una organización quiere excluir el sitio completo, pero permitir el uso de los materiales de prensa, la configuración propuesta es:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
La lógica es deliberadamente conocida. Disallow expresa una preferencia contraria al entrenamiento para la ruta indicada y Allow expresa una preferencia favorable. Si no existe un grupo con ese token, el sitio no ha manifestado una opción mediante este mecanismo. Además, el comodín User-Agent: * no debe interpretarse como equivalente a la señal común.
Hay una distinción decisiva: el token representa una preferencia de uso, no una orden de bloqueo de tráfico. Un proveedor puede decidir no descargar un recurso si su único propósito era entrenar, pero el estándar propuesto no obliga técnicamente al servidor a impedir el acceso. Para bloquear un bot se requieren reglas dirigidas al agente específico o controles en CDN, firewall y servidor.
Entrenamiento, búsqueda y grounding no son lo mismo
La confusión entre estas funciones puede causar una pérdida de visibilidad evitable. La IETF define entrenamiento como usar un activo para modificar los parámetros aprendidos de un modelo generativo. Es un uso distinto de recuperar una página en tiempo real para responder una consulta, construir un índice, clasificar documentos o mostrar una cita con enlace.
| Función | Qué hace | Control relevante | Riesgo de confusión |
|---|---|---|---|
| Entrenamiento | Modifica parámetros de un modelo futuro. | __usage_ai-training y tokens propios. |
Creer que excluirse elimina citas actuales. |
| Búsqueda | Descubre e indexa páginas para resultados. | Bots de búsqueda, como OAI-SearchBot. | Bloquear el bot que puede mostrar la fuente. |
| Grounding | Usa información recuperada para fundamentar una respuesta. | Depende de la política de cada plataforma. | Equipararlo con entrenamiento permanente. |
| Acción del usuario | Abre una URL porque una persona lo solicita. | Fetchers activados por el usuario. | Suponer que robots.txt siempre se aplica igual. |
La documentación oficial de OpenAI confirma que sus opciones son independientes. Un webmaster puede permitir OAI-SearchBot para aparecer en la búsqueda de ChatGPT y, al mismo tiempo, rechazar GPTBot para indicar que el contenido no debe utilizarse en entrenamiento. OpenAI advierte que un ajuste en robots.txt puede tardar cerca de 24 horas en reflejarse en sus sistemas de búsqueda.
Qué significa para medios y empresas en Chile
Para un medio digital, el valor no está solo en impedir una descarga. Está en documentar una política editorial coherente. Una empresa puede decidir que sus noticias, investigaciones o manuales permanezcan visibles y citables, pero no autorizar que alimenten el entrenamiento de futuros modelos. Otra podría permitir el uso de un repositorio abierto y reservar contenidos de pago, informes comerciales o material licenciado.
El control por rutas facilita esa segmentación, aunque exige gobernanza. Las áreas legal, editorial, SEO y tecnología deben acordar qué se protege, qué se mantiene disponible y cuál es el resultado de negocio esperado. En Chile, además, conviene revisar contratos con agencias, proveedores de CDN, plataformas de membresía y distribuidores de contenido. Una preferencia publicada en el dominio principal no corrige automáticamente copias alojadas en terceros ni reemplaza licencias.
Desde el punto de vista SEO, la recomendación prudente es separar tres objetivos: indexación tradicional, visibilidad en respuestas generativas y uso para entrenamiento. Bloquear todo con una regla amplia puede preservar contenido frente a ciertos rastreadores, pero también reducir descubrimiento, referencias y tráfico. No existe una configuración universalmente correcta.
La Solución Tecnológica: auditoría por capas antes de editar
La respuesta técnica responsable es una auditoría de cuatro capas. Primero, inventariar los agentes que visitan el sitio mediante registros del servidor, analítica de bots y rangos IP publicados. Segundo, clasificar cada agente por propósito: entrenamiento, búsqueda, publicidad, grounding o acción solicitada por un usuario. Tercero, definir reglas por directorio según sensibilidad y valor editorial. Cuarto, comprobar que robots.txt, CDN y firewall expresen la misma decisión, sin contradicciones.
En WordPress, editar el archivo sin revisar plugins SEO, sistemas de caché o reglas administradas por Cloudflare puede provocar que una capa sobrescriba a otra. La verificación debe consultar la URL pública /robots.txt, probar rutas críticas y revisar los logs después del cambio. También es recomendable conservar una versión fechada de la política y registrar quién aprobó cada modificación.
Durante la transición, mantener los controles específicos puede ser necesario. El anuncio de OpenAI dice que el nuevo mecanismo no reemplaza sus controles existentes, mientras Google proyecta su adopción para 2027. El token común simplifica el futuro, pero todavía no demuestra una cobertura universal ni entrega una barrera técnica contra rastreadores que no cooperen.
Qué no hacer con la nueva señal
- No copiar una receta sin definir el objetivo. Excluir entrenamiento, impedir rastreo y desaparecer de una respuesta generativa son decisiones diferentes.
- No mezclar el token con un grupo comodín por accidente. Una estructura incorrecta puede terminar bloqueando bots legítimos para todo el sitio.
- No eliminar de inmediato reglas específicas. La adopción será gradual y cada proveedor mantiene plazos y controles propios.
- No presentar robots.txt como una medida de seguridad. Es una señal voluntaria. Los contenidos confidenciales deben protegerse con autenticación y controles de acceso reales.
- No medir el éxito solo por visitas. Hay que observar rastreo, citas, referencias, conversiones y eventuales cambios en la visibilidad orgánica.
Microsoft resume el principio de forma útil: las preferencias de entrenamiento y grounding pueden gestionarse de manera independiente, sin alterar por sí mismas la elegibilidad en los resultados normales de Bing. Su anuncio para publishers refuerza que la web con IA necesitará controles más precisos que un simple permitir o bloquear.
Preguntas frecuentes
¿Qué es el control robots.txt para IA anunciado por OpenAI?
Es una señal común basada en el token __usage_ai-training. Permite expresar por rutas si el contenido puede usarse para modificar los parámetros de modelos generativos. OpenAI anunció que la implementará durante los próximos meses.
¿Bloquear el entrenamiento impide aparecer en ChatGPT?
No necesariamente. OpenAI separa GPTBot, destinado al contenido que puede utilizarse en entrenamiento, de OAI-SearchBot, utilizado para mostrar sitios en las funciones de búsqueda de ChatGPT. Las reglas deben configurarse según cada propósito.
¿La señal común ya es un estándar definitivo?
No. El documento publicado el 30 de octubre de 2026 es un Internet-Draft presentado en la IETF. Es un trabajo en progreso, puede cambiar antes de convertirse en estándar y su cumplimiento sigue siendo voluntario.
¿robots.txt puede proteger contenido confidencial?
No. robots.txt comunica preferencias a rastreadores cooperativos, pero no funciona como autenticación ni como firewall. Los documentos confidenciales requieren control de acceso, permisos, monitoreo y medidas de seguridad en servidor.
¿Qué debe revisar una empresa chilena antes de aplicarlo?
Debe definir su política de entrenamiento, búsqueda y citas, revisar los bots actuales, segmentar rutas, validar la configuración pública y monitorear logs. También conviene mantener reglas específicas mientras los proveedores completan la adopción del token común.
